项目 / COMPUTER VISION · 3D GAUSSIANS
ML-SHARP
把一张照片变成可移动视角的三维场景
- 模型部署 / 后处理实验
- 本地实验 · 原版效果展示
- PyTorch / CUDA / 3DGS
- No. 07
照片背后,是一组可渲染的三维高斯
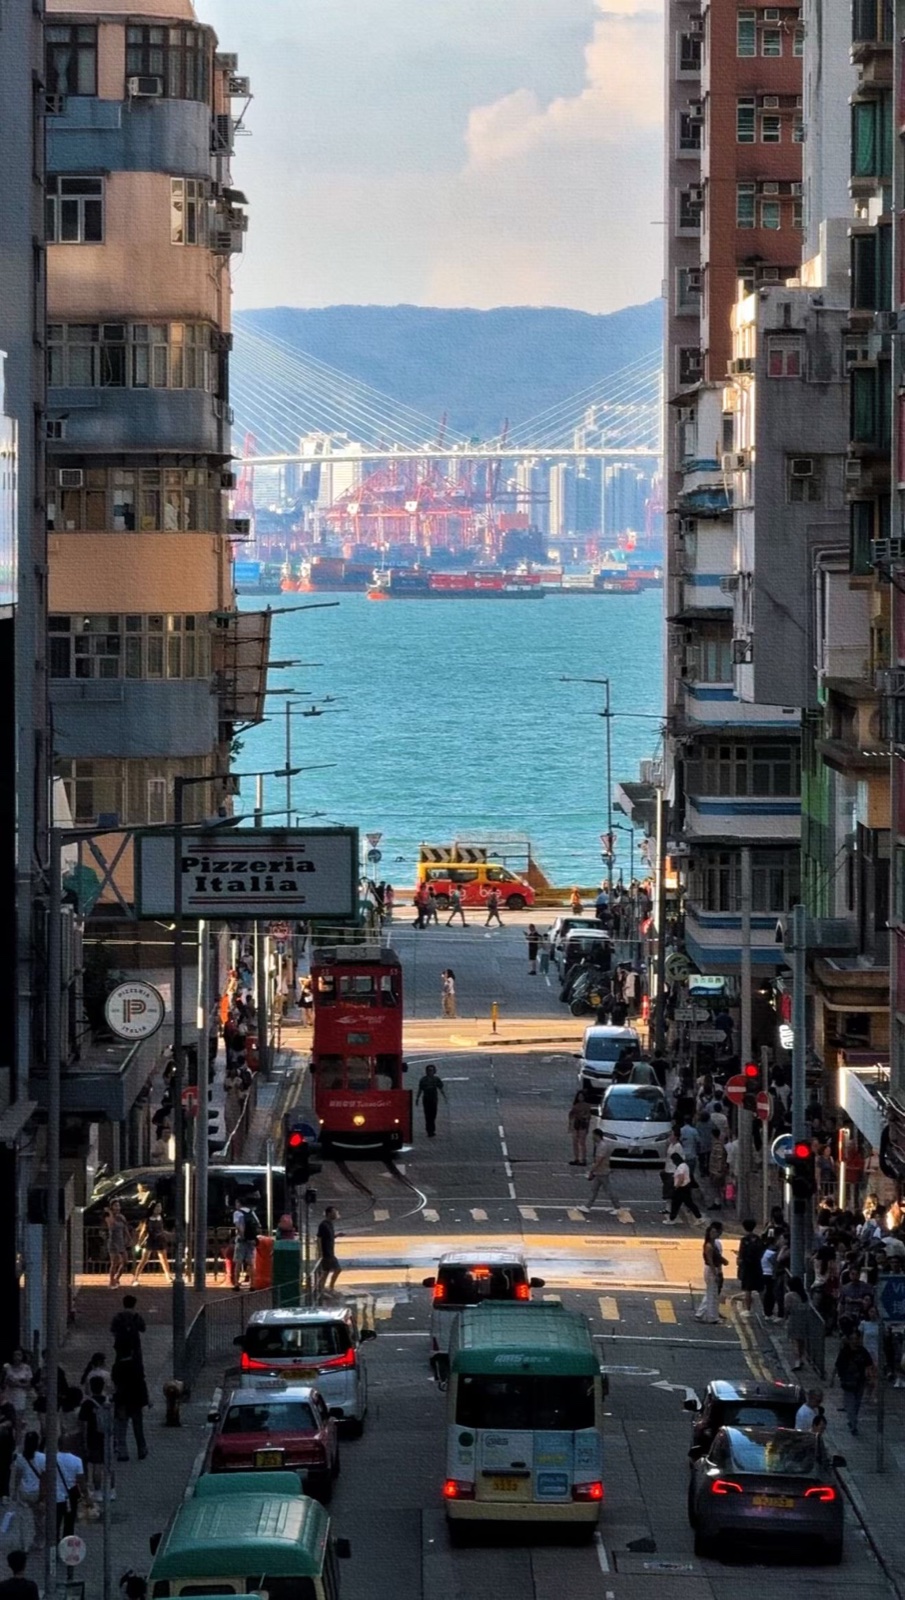
一张街道望海的照片,近处是车辆,两侧是楼房,远处是海面和桥。我把它输入 SHARP,再让虚拟相机稍微移动:车辆与远景产生不同幅度的位移,原本固定在照片里的街道,开始有了向纵深延伸的感觉。
吸引我的正是这种细微的变化。没有绕着现场拍摄,也没有手动搭建模型,只凭一张照片,就能重新观察画面里的空间关系。
我基于 Apple 的 SHARP 搭建了单图推理、三维高斯导出、视角渲染和后处理分析流程。这篇展示选取海边街道、海岸悬崖、古建筑与树木、窗边座椅和校园走廊五个场景。模型沿用官方权重;我的工作主要放在部署、结果检视和几何后处理上,没有重新训练基础模型。
SHARP 从单张照片预测场景的三维高斯表示,再从附近的新视角渲染图像。视频里的移动来自虚拟相机,而不是对原图做一次平移或缩放。
可以把每个 Gaussian 理解成空间中一个带颜色的小椭球,具有位置、尺度、方向和不透明度。渲染时,这些椭球投影到画面上,按照遮挡关系叠加出图像。在本次使用的版本里,每个场景包含两层 768 × 768 的 Gaussian,共 1,179,648 个,保存在约 63 MiB 的 PLY 文件中。
这份 PLY 不是传统的三角网格。它更适合交给支持 Gaussian Splatting 的查看器,用来观察照片附近的视角变化。对于博客展示,也可以先离线渲染成视频,让读者不必下载整个三维场景。
这里有一个重要前提:照片没拍到的地方,没有直接的观测依据。我关注的是小范围移动带来的视差,而不是把单张照片还原成可以任意漫游的完整世界。这也符合 SHARP 论文对附近视角合成的定位。
在 8GB 显存上跑通完整流程
我把推理与渲染放在 Windows 的 WSL2 环境里,使用 RTX 3070 Laptop 8GB;Mac 负责整理照片、取回产物和查看结果。整条流程按下面的顺序执行:
输入照片 → 官方 FP32 推理 → Gaussian PLY
                             ↓
                     重新加载、检查参数
                             ↓
                    沿官方轨迹渲染原版视频
                             ↓
                    后处理分析、标记修改位置
这里展示的五张照片都完成了导出、重新加载和移动视角渲染。预测阶段约为 13–17 秒,包含输入处理、模型前向和高斯后处理;这只是当前设备上的单次运行记录,不是纯模型耗时或严格的性能基准。运行时显存已经接近设备上限,因此我采用逐张处理,而不是并行推理。
我也没有把“文件成功写出来”当作结束。PLY 需要重新加载,检查解码后的参数,并实际渲染。这里碰到过一个很有代表性的细节:文件中的 opacity 保存的是不透明度的 logit,完全不透明的 alpha = 1 对应正无穷。直接禁止所有无穷值,会把合法结果误判为损坏。检查应落在解码后的不透明度及其他参数上,而不是只看存储字段是否有限。
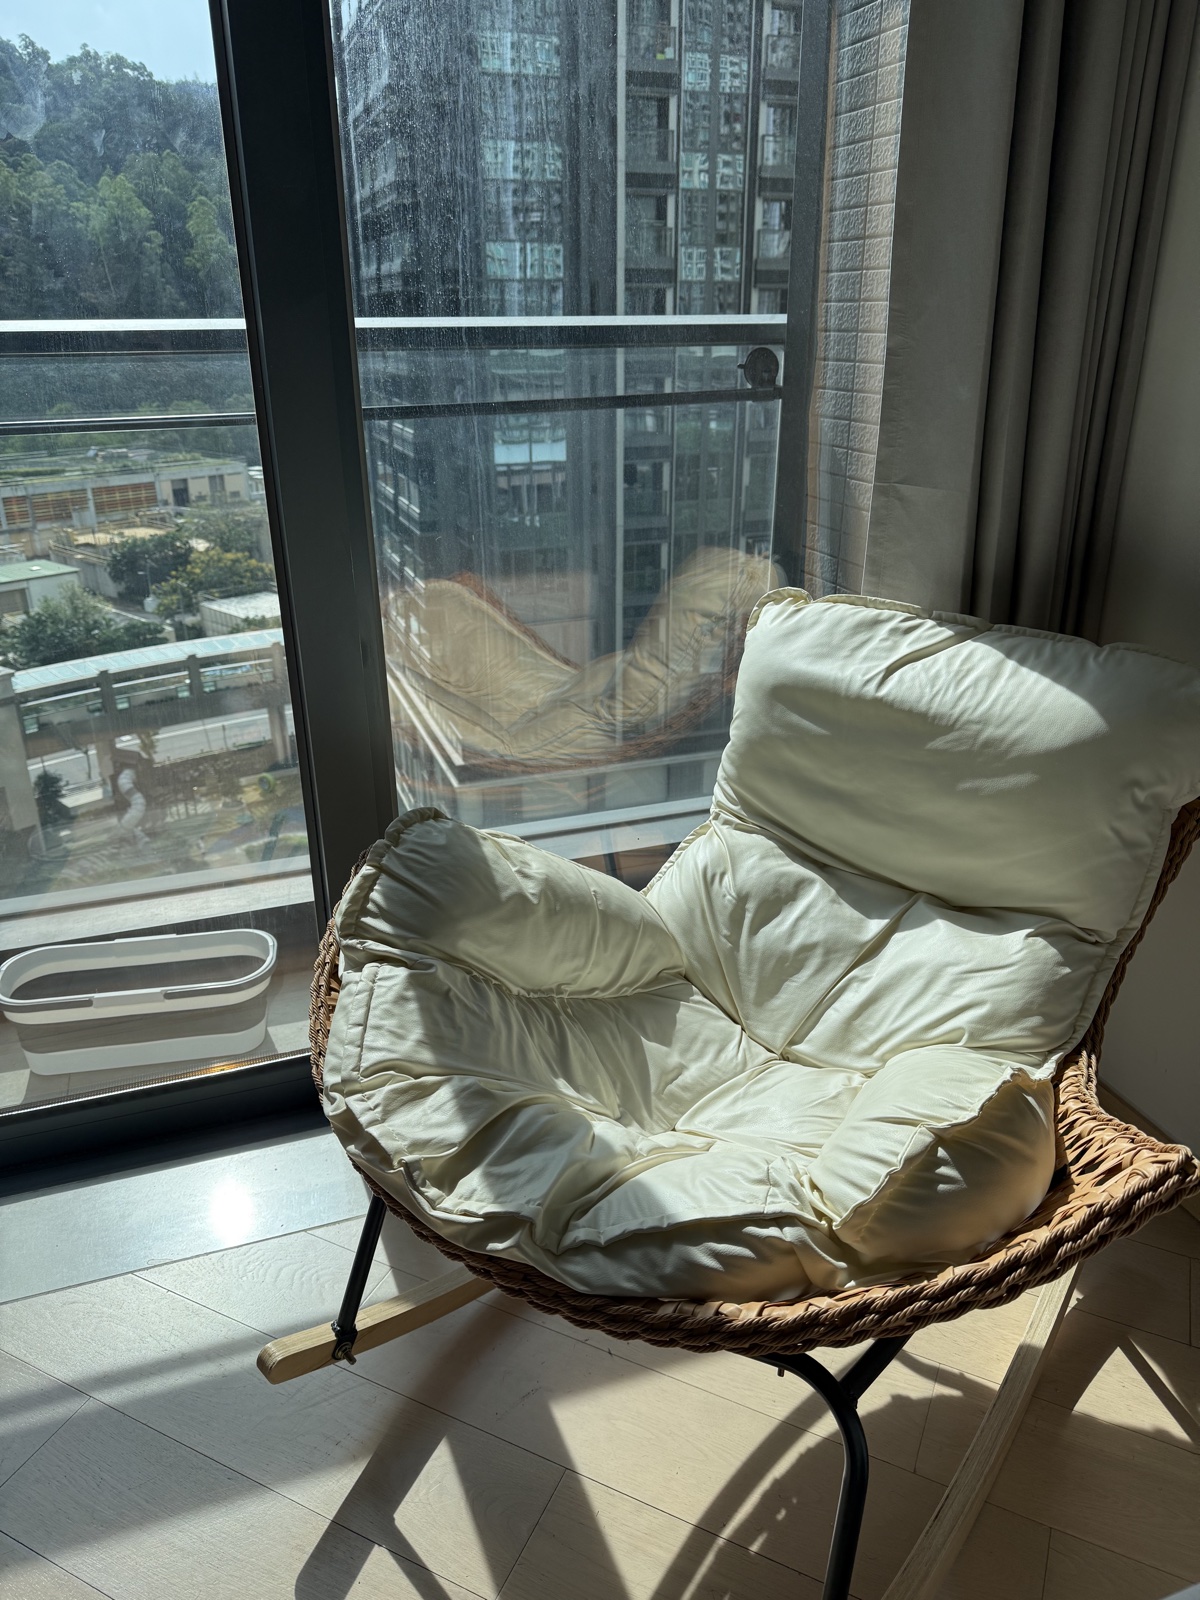
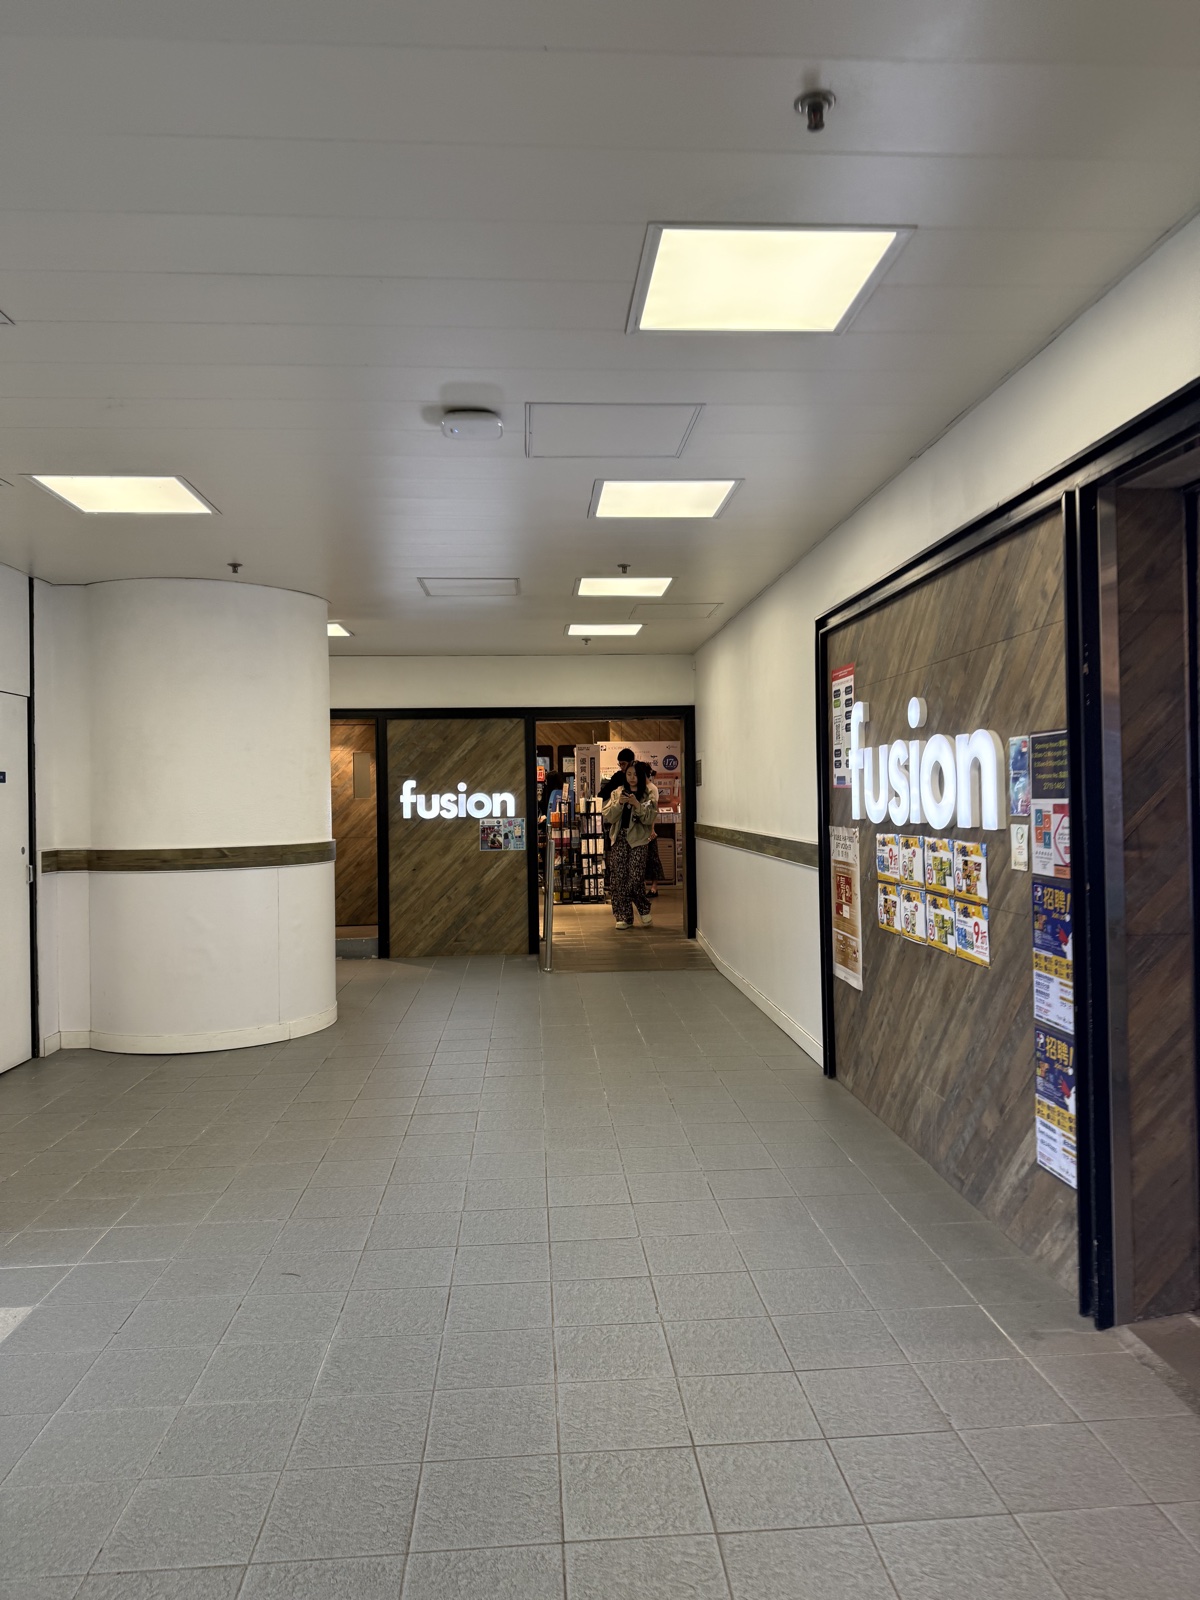
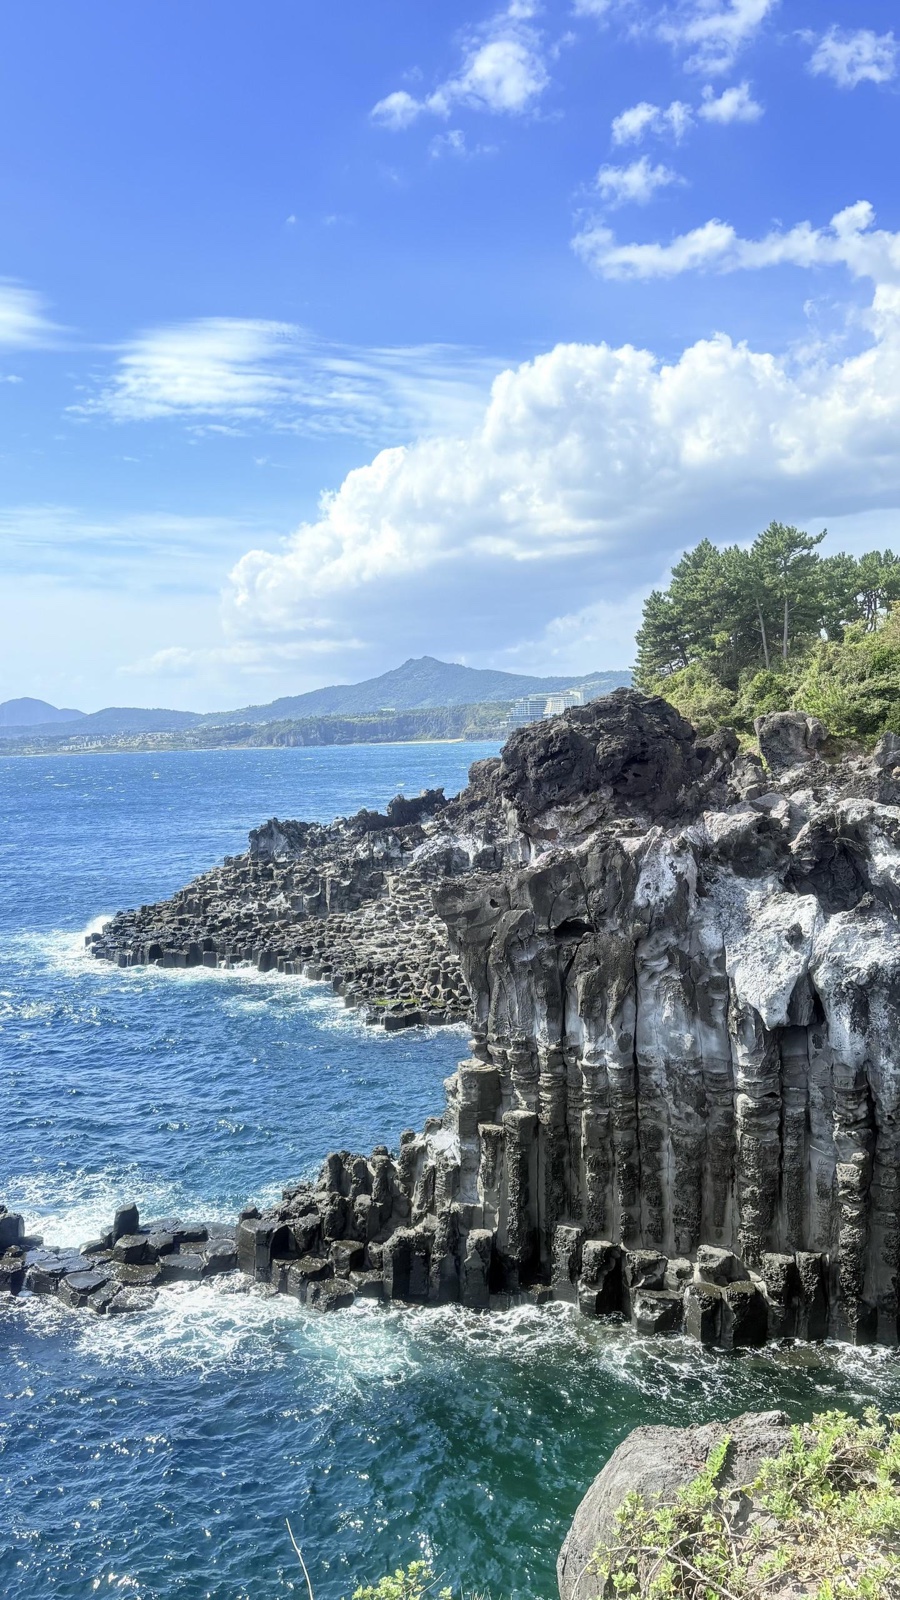
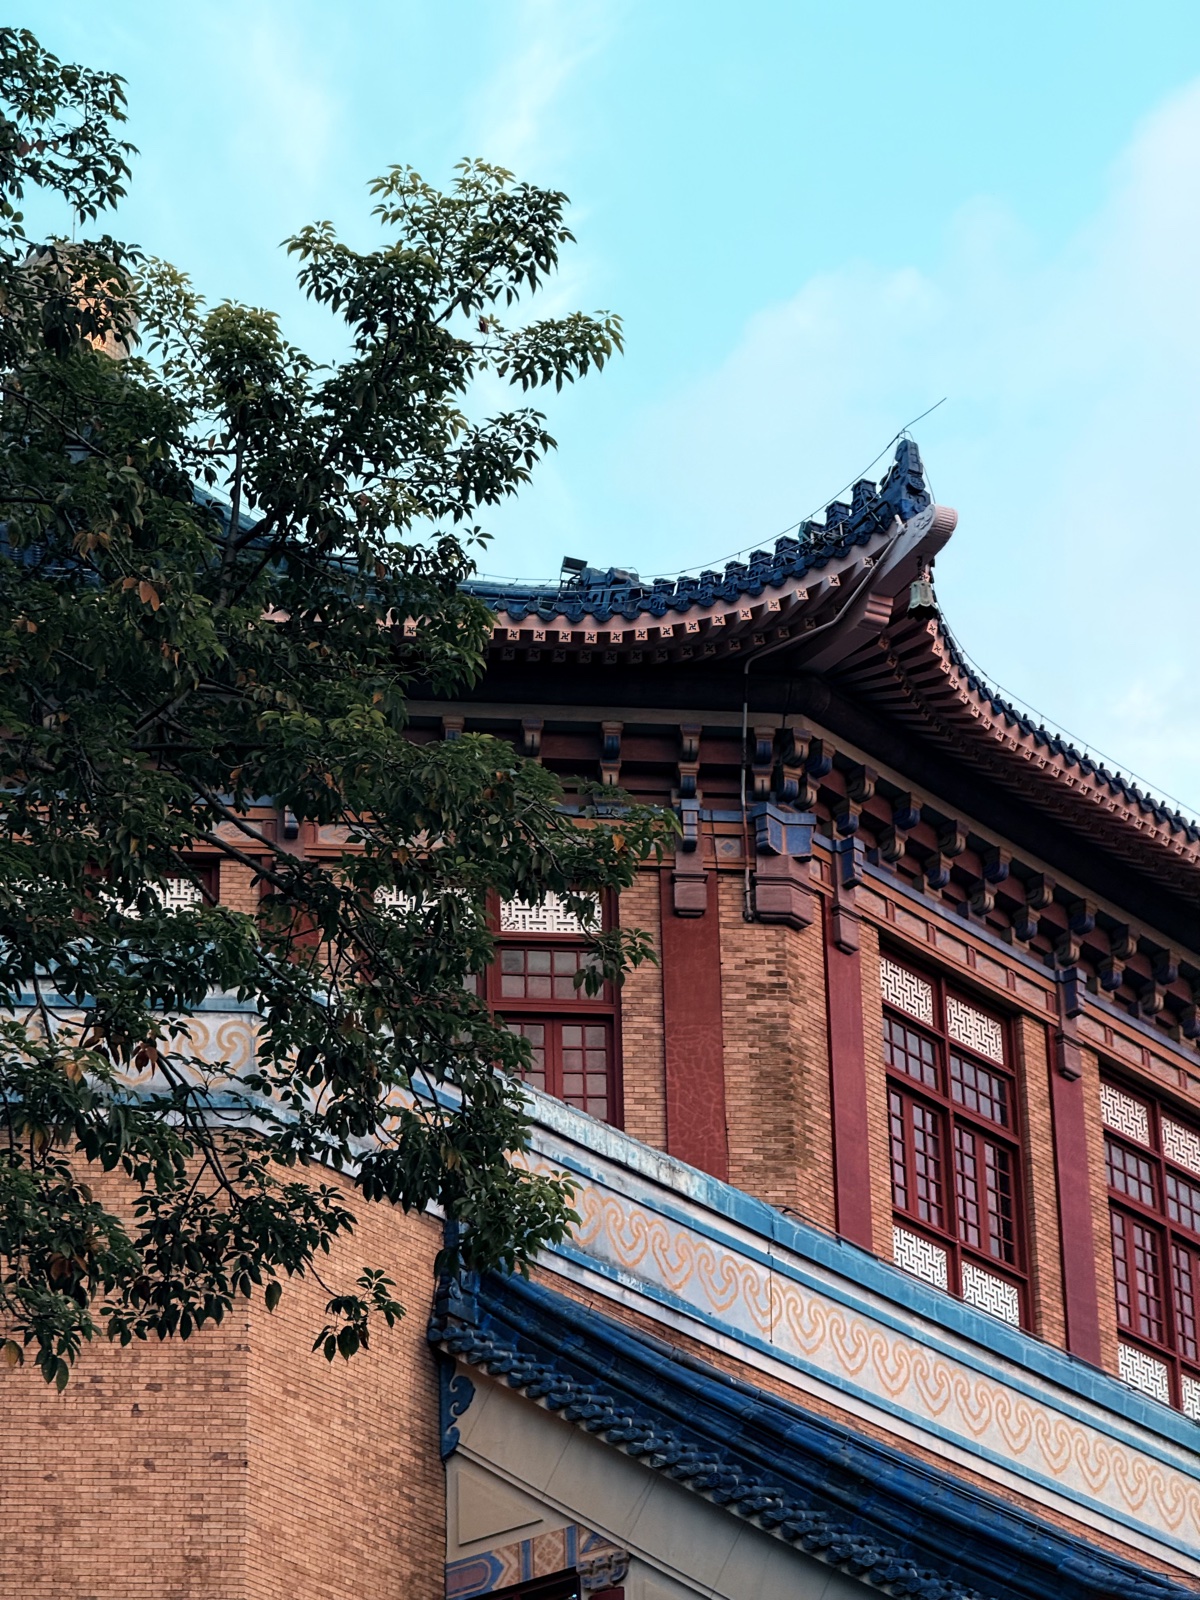
用于展示的五组场景分别是海边街道、海岸悬崖、古建筑与树木、窗边座椅和校园走廊。它们提供了不同的观察对象:街景适合看前后景视差,树木和建筑轮廓适合检查细节,室内场景则便于观察遮挡与空间结构。主体布局在这些结果中得到了保留,不过细纹理会有平滑,移动后也会暴露正面静帧里不明显的问题。
每个场景配一张输入照片、一段两秒原版视频和一张修改位置图。视频沿用官方的附近视角轨迹,展示原版 SHARP 的视差效果,没有应用下面介绍的后处理;修改位置图则单独记录后处理动了哪些 Gaussian。
两种后处理,分别处理两类问题
原版结果已经能呈现视差,我进一步尝试了两种不需要重新训练的后处理。一个调整局部深度,一个删除低贡献的 Gaussian。两者分别从原版出发,不叠加,方便判断变化来自哪里。
沿相机射线修正局部深度
第一种方法针对局部孤立的深度异常:如果周围是一片相对连续的表面,中间某个 Gaussian 却明显偏离,能否把它往邻域深度拉回一点?
难点在于,真实物体的边缘也会出现深度突变。树枝、椅子轮廓和前后物体交界,都不能简单地按“不平滑”处理。我在两层 Gaussian 中分别检查 5 × 5 邻域的对数深度,用中位数和稳健尺度判断异常,同时保护图像边缘、真实深度跳变和高贡献区域。模型输出还带有位置偏移,因此网格里相邻的点未必在空间上相邻;投影偏移过大的邻域也会跳过。
通过筛选的点沿原相机射线移动,单次幅度限制在 3% 以内,并同步缩放 Gaussian 的三个主轴。用简化公式表示就是:
位置 p' = r × p
尺度 s' = r × s
0.97 ≤ r ≤ 1.03
这样可以保持原视角的投影中心和近似投影大小,不直接改变颜色与不透明度。但深度变化仍可能影响遮挡,因此还需要保护两层的前后关系,并重新渲染检查。
它处理的是局部异常,无法补出照片没有提供的背面,也不适合修复整片错误表面。
按多视角贡献裁剪 Gaussian
第二种方法关心的是:一个场景里超过一百万个 Gaussian,是否有一些在当前观察范围内几乎没有贡献?
我参考了 LightGaussian 基于多视角重要性裁剪的思路,在原视角和多个附近视角统计渲染贡献,再结合边缘重要性与不透明度筛选。这里采用的是自己设定的规则,没有复现它完整的压缩与恢复流程。
贡献统计利用了可微渲染器:给 Gaussian 设置临时颜色通道,对渲染结果求梯度,取得每个点在 alpha 合成中的权重。梯度在这里用于统计,不用于训练模型。跨视角取最大贡献,而不是平均值,是为了保留那些只在某个角度显露、但仍然重要的点。
只有低贡献、远离重要边缘、同时满足不透明度条件的点,才会进入裁剪候选。每层设置最多 10% 的删除预算,候选不足就少删,不为了凑比例损伤结构。
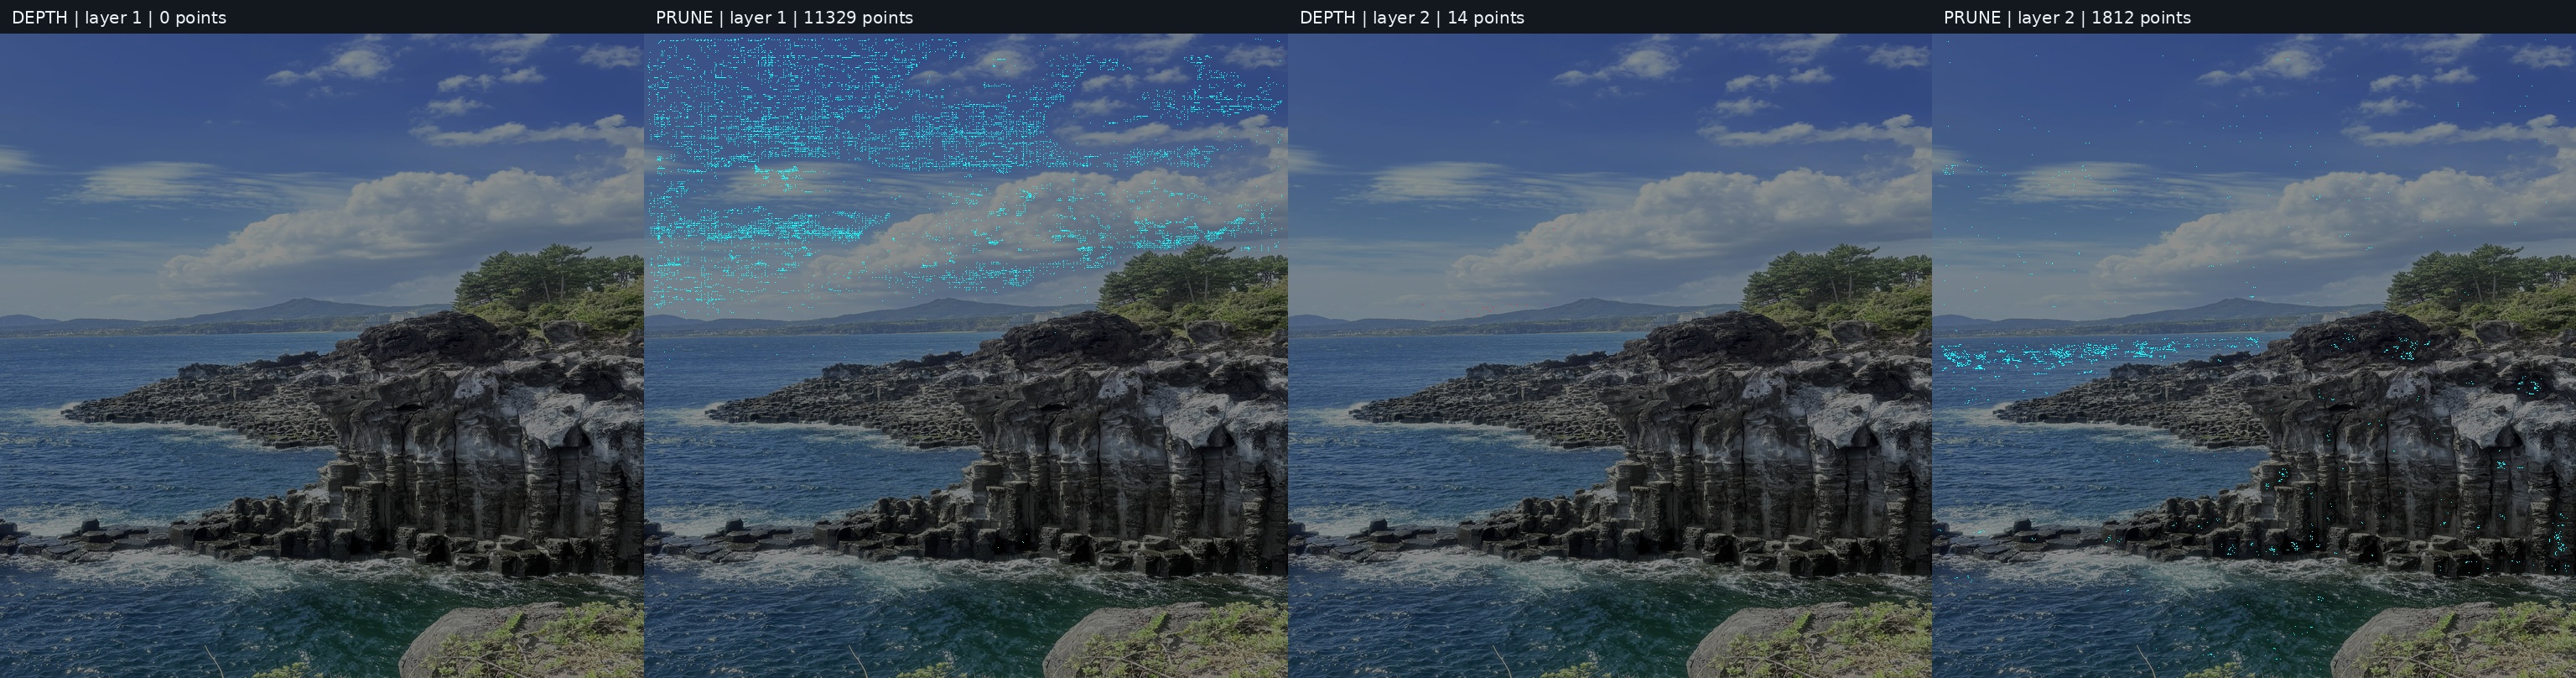
修改位置图,能说明什么
比较这些版本时,我固定了一个条件:原版、深度修正版和裁剪版,逐帧使用完全相同的相机内参与外参。
这比看起来更重要。如果每个版本都按自己的深度重新生成路径,模型修改就可能同时改变相机运动幅度,最终很难判断差异到底来自几何还是镜头。
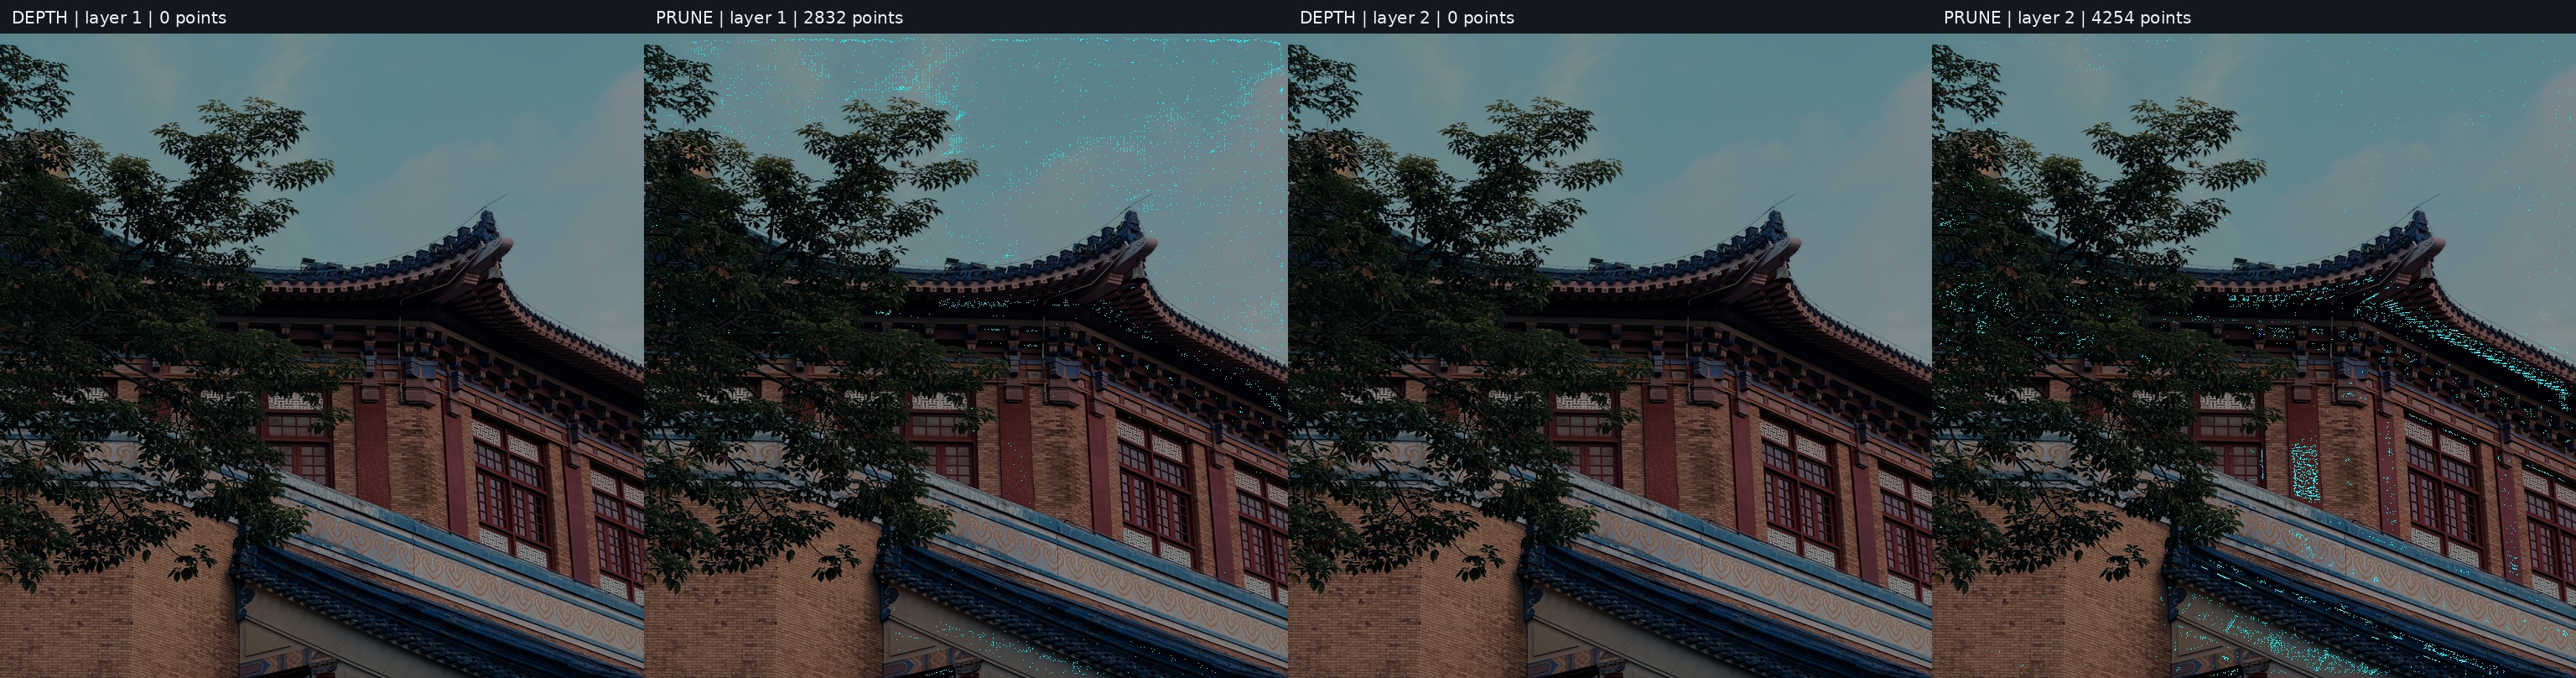
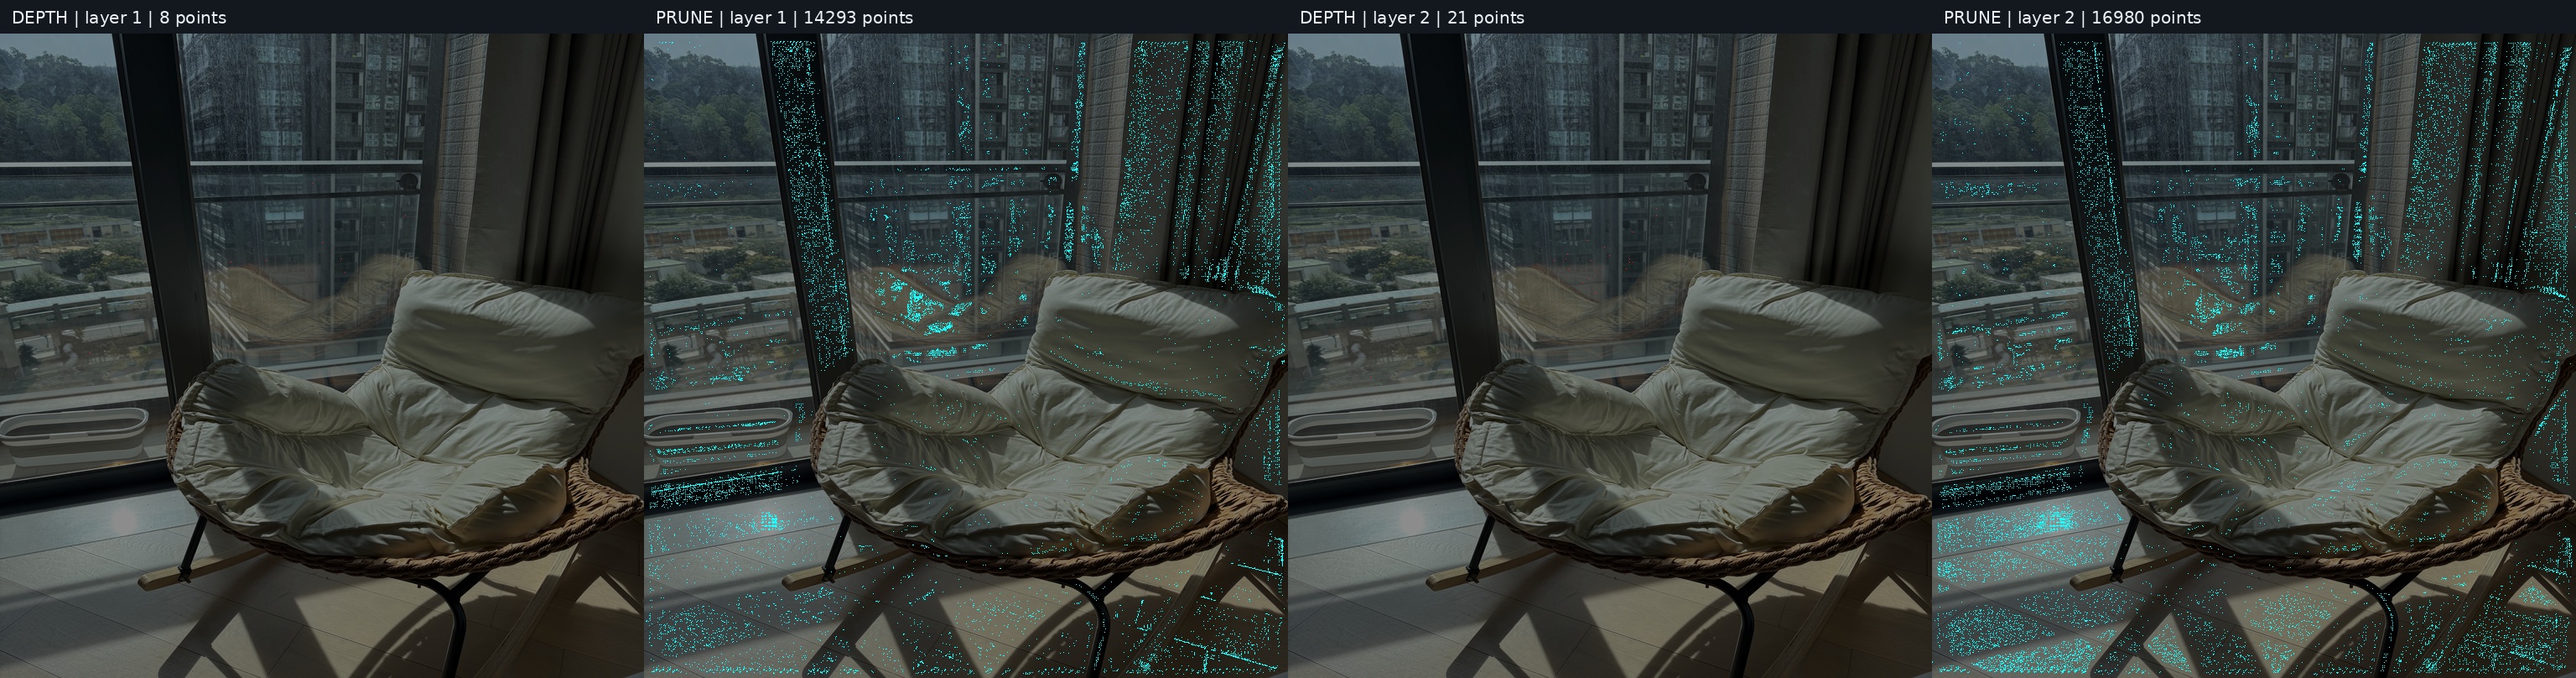
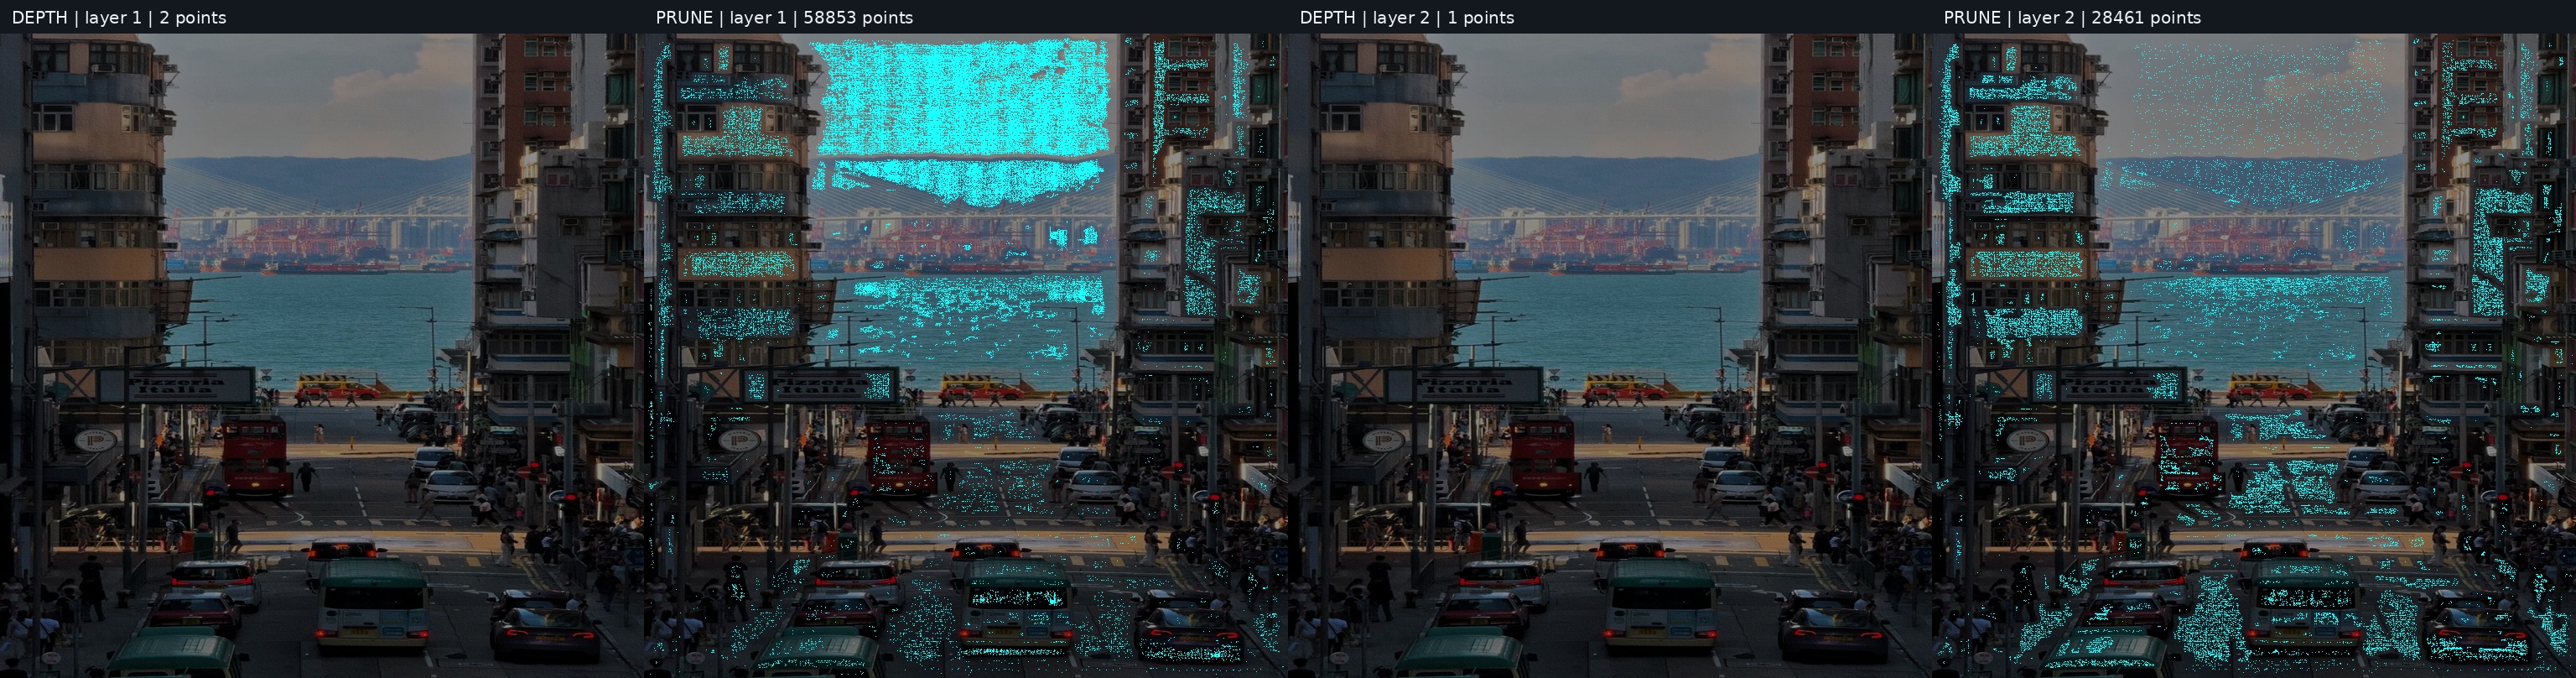
每张修改位置图分成四栏,从左到右依次是第一层的深度修正、第一层的裁剪、第二层的深度修正、第二层的裁剪。红色标记实际调整过深度的点,青色标记被裁剪的点;两层是模型输出的结构,不是处理前后的两个版本。
这张图能回答算法作用到了哪些区域,但不是误差热图,也不是“修好了多少”的证明。标记按照模型输出网格排列,不等于最终画面中的精确投影位置;删除一个 Gaussian,也不意味着删除同位置的一个像素。
五个展示场景的结果如下:
这五个场景合计只调整了 46 个 Gaussian,其中古建筑与树木、校园走廊没有任何点通过全部深度修正条件。对边缘和遮挡的保护,让这轮处理相当保守。街道图中,红点只有三个,而青色裁剪标记密集得多;但标记数量的差异,不能直接换算成画质改善。
裁剪的存储收益更明确。海边街道删除了约 7.40% 的点,PLY 从约 63 MiB 减到 58.34 MiB,在本轮附近视角中仍与原版非常接近。不过我没有测量裁剪后的播放帧率,不能把点数减少直接写成渲染加速。
本轮没有观察到明显的画质提升。相对原版计算的 PSNR 很高,只能说明修改幅度小;没有真实深度或标定新视角作为参照,不能据此认定几何更准确。展示中的原版视频用于观察模型效果,修改位置图用于解释后处理行为,两者都不应被当作后处理改善画质的证明。
检查候选统计还发现,所有层的候选数都没达到 10% 的预算,符合条件的点已经全部删除。因此,这一轮真正限制裁剪范围的是前面的筛选条件,单纯把预算上调不会改变结果。下一轮更值得做的是逐项检查保护条件,而不是继续提高一个尚未用满的上限。
我想继续推进的方向
目前的展示保留五组输入照片、原版视频和修改位置图。下一步会先选一个有明确伪影的场景,固定相机路径,一次只放宽一类条件,检查改善是否值得付出细节损失。外部深度对齐也可以继续尝试,但需要先解决尺度、焦距和坐标系对应的问题,不能直接拿另一份预测覆盖现有几何。
展示端则更适合从小幅度交互开始:让照片跟随鼠标或设备姿态产生受控的视差,而不是默认允许大范围漫游。这还是后续方向,当前展示使用离线生成的视频,并未提供实时交互查看器。
我喜欢这类项目的原因,是一张熟悉的照片可以有另一种观看方式。车、楼房和远处的海不再以相同的速度掠过画面,空间感就从这种差别中出现了。接下来要打磨的,是在多大范围内,它既保留照片的观感,也经得起换个角度看。